
Odborný článek
Digitalizace ve vzdělávání
26. 10. 2026
Bořivoj Brdička
Další tvorba autora26. 10. 2026
Bořivoj Brdička
Další tvorba autoraZpráva o tom, proč velké jazykové modely pro své trénování potřebují obsah AI neovlivněný založená na práci známého anglického odborníka Martina Wellera.
Média v nedávné době šířila zprávu o tom, že společnosti provozující velké jazykové modely (LLM) hromadně vykupují staré knihy i jiné zdroje textů, na něž se již nevztahují autorská práva a jejichž obsah zaručeně nebyl vytvořen s pomocí AI. Důvody jsou natolik zajímavé, že stojí za to se nad nimi zamyslet. Budeme se přitom držet výkladu nám známého anglického experta Martina Wellera [1].
Problém stojící v pozadí je způsoben potřebou LLM rozšiřovat obsah, na němž zdokonalují své schopnosti. Ukazuje se totiž, že většina toho, co je běžně k dispozici online, již bylo zpracováno, a tak tyto modely začínají ke svému trénování používat obsah, který dříve již samy (třeba jen částečně) generovaly. To jim bohužel brání ve zdokonalování. Někteří odborníci mluví dokonce o možném kolapsu.
Existuje reálná možnost, že následkem opakujících se cyklů trénování, které jsou živeny vlastním obsahem, se může zvýšit pravděpodobnost šíření dezinformací a halucinací, ale také že tyto modely mohou mít méně rozmanitého univerzálního materiálu, ze kterého by mohly čerpat.
Vzhledem k tomu, že poskytovatelé umělé inteligence mezi sebou tvrdě soutěží, je pro ně nezbytné najít způsoby, jak se tomuto kolapsu vyhnout. Jedním z nich je sběr staršího obsahu. S konkurenčním bojem je bohužel spojena i poněkud zákeřná snaha některých společností nedat nikomu možnost získané zdroje též použít. Důsledkem je jejich likvidace poté, co byly digitalizovány. Nutně se nemusí jednat jen o ničení starých knih, ale třeba i starých zvukových nahrávek, obrázků či filmů. Znamená to, že původních analogových zdrojů bude ubývat a jednou se vyčerpají.
Není vyloučeno, že v budoucnosti začneme vnímat veškerou skutečně lidskou interakci neinfikovanou AI jako potenciálně exkluzivní obsah použitelný ke sběru originálních dat pro trénování modelů. Že takový obsah bude mít svou cenu a stane se zajímavým obchodním artiklem. Je otázkou, co to udělá se sektorem „otevřených vzdělávacích zdrojů“ (OER) a licencí CC, kterou používáme i my. Ale otázek je mnohem více.
Existují platformy podporující tvůrčí psaní (Martin používá Reedsy) a mnoho online nástrojů, které podporují psaní s formátováním, analytikou a poradenstvím. Zde je k dispozici originální obsah, který lze použít. Ve skutečnosti se pro trénink AI hodí i všechny změny, úpravy a vylepšení, které uživatelé dělají. Někteří poskytovatelé již dnes nabízejí exkluzivitu s možností ovládat, kterým modelům umožní uživatel přístup.
To vše ale bledne v porovnání s produkcí obsahu, který vzniká v rámci vzdělávání. Existuje obrovské množství výstupů a dalších artefaktů. A jejich variace, spolu s revizemi a úpravami a všemi těmi konverzacemi realizovanými na online fórech. Toto je bohatý, do značné míry nekonečný, lidmi generovaný digitální obsah, na kterém se mohou modely umělé inteligence trénovat. Vzhledem k tomu, že téměř všechny školy používají nějakou cloudovou platformu, jsou tato data minimálně jejímu poskytovateli k dispozici. Je zřejmé, že mohou být využita a třeba i prodána.
Nabízí se tak trochu fantastická představa budoucnosti, v níž se originální lidská tvorba obsahu stane komoditou podobnou potravě, kterou velký stroj vysaje, a to bez ohledu na jeho kvalitu. V situaci, kdy AI jako infekce proniká všude, je ironií, že sama o obsah, který byl AI ovlivněn, nemá zájem. Třeba to dojde tak daleko, že firmy působící v oboru začnou studentům pomáhat vyhýbat se využití AI, aby zvýšily pravděpodobnost její nepřítomnosti v obsahu, který později použijí k trénování svých modelů.
Důsledek je evidentní. Originální obsah generovaný člověkem bude mít i nadále smysl, navzdory všem předpovědím o nahrazování lidské tvorby AI.
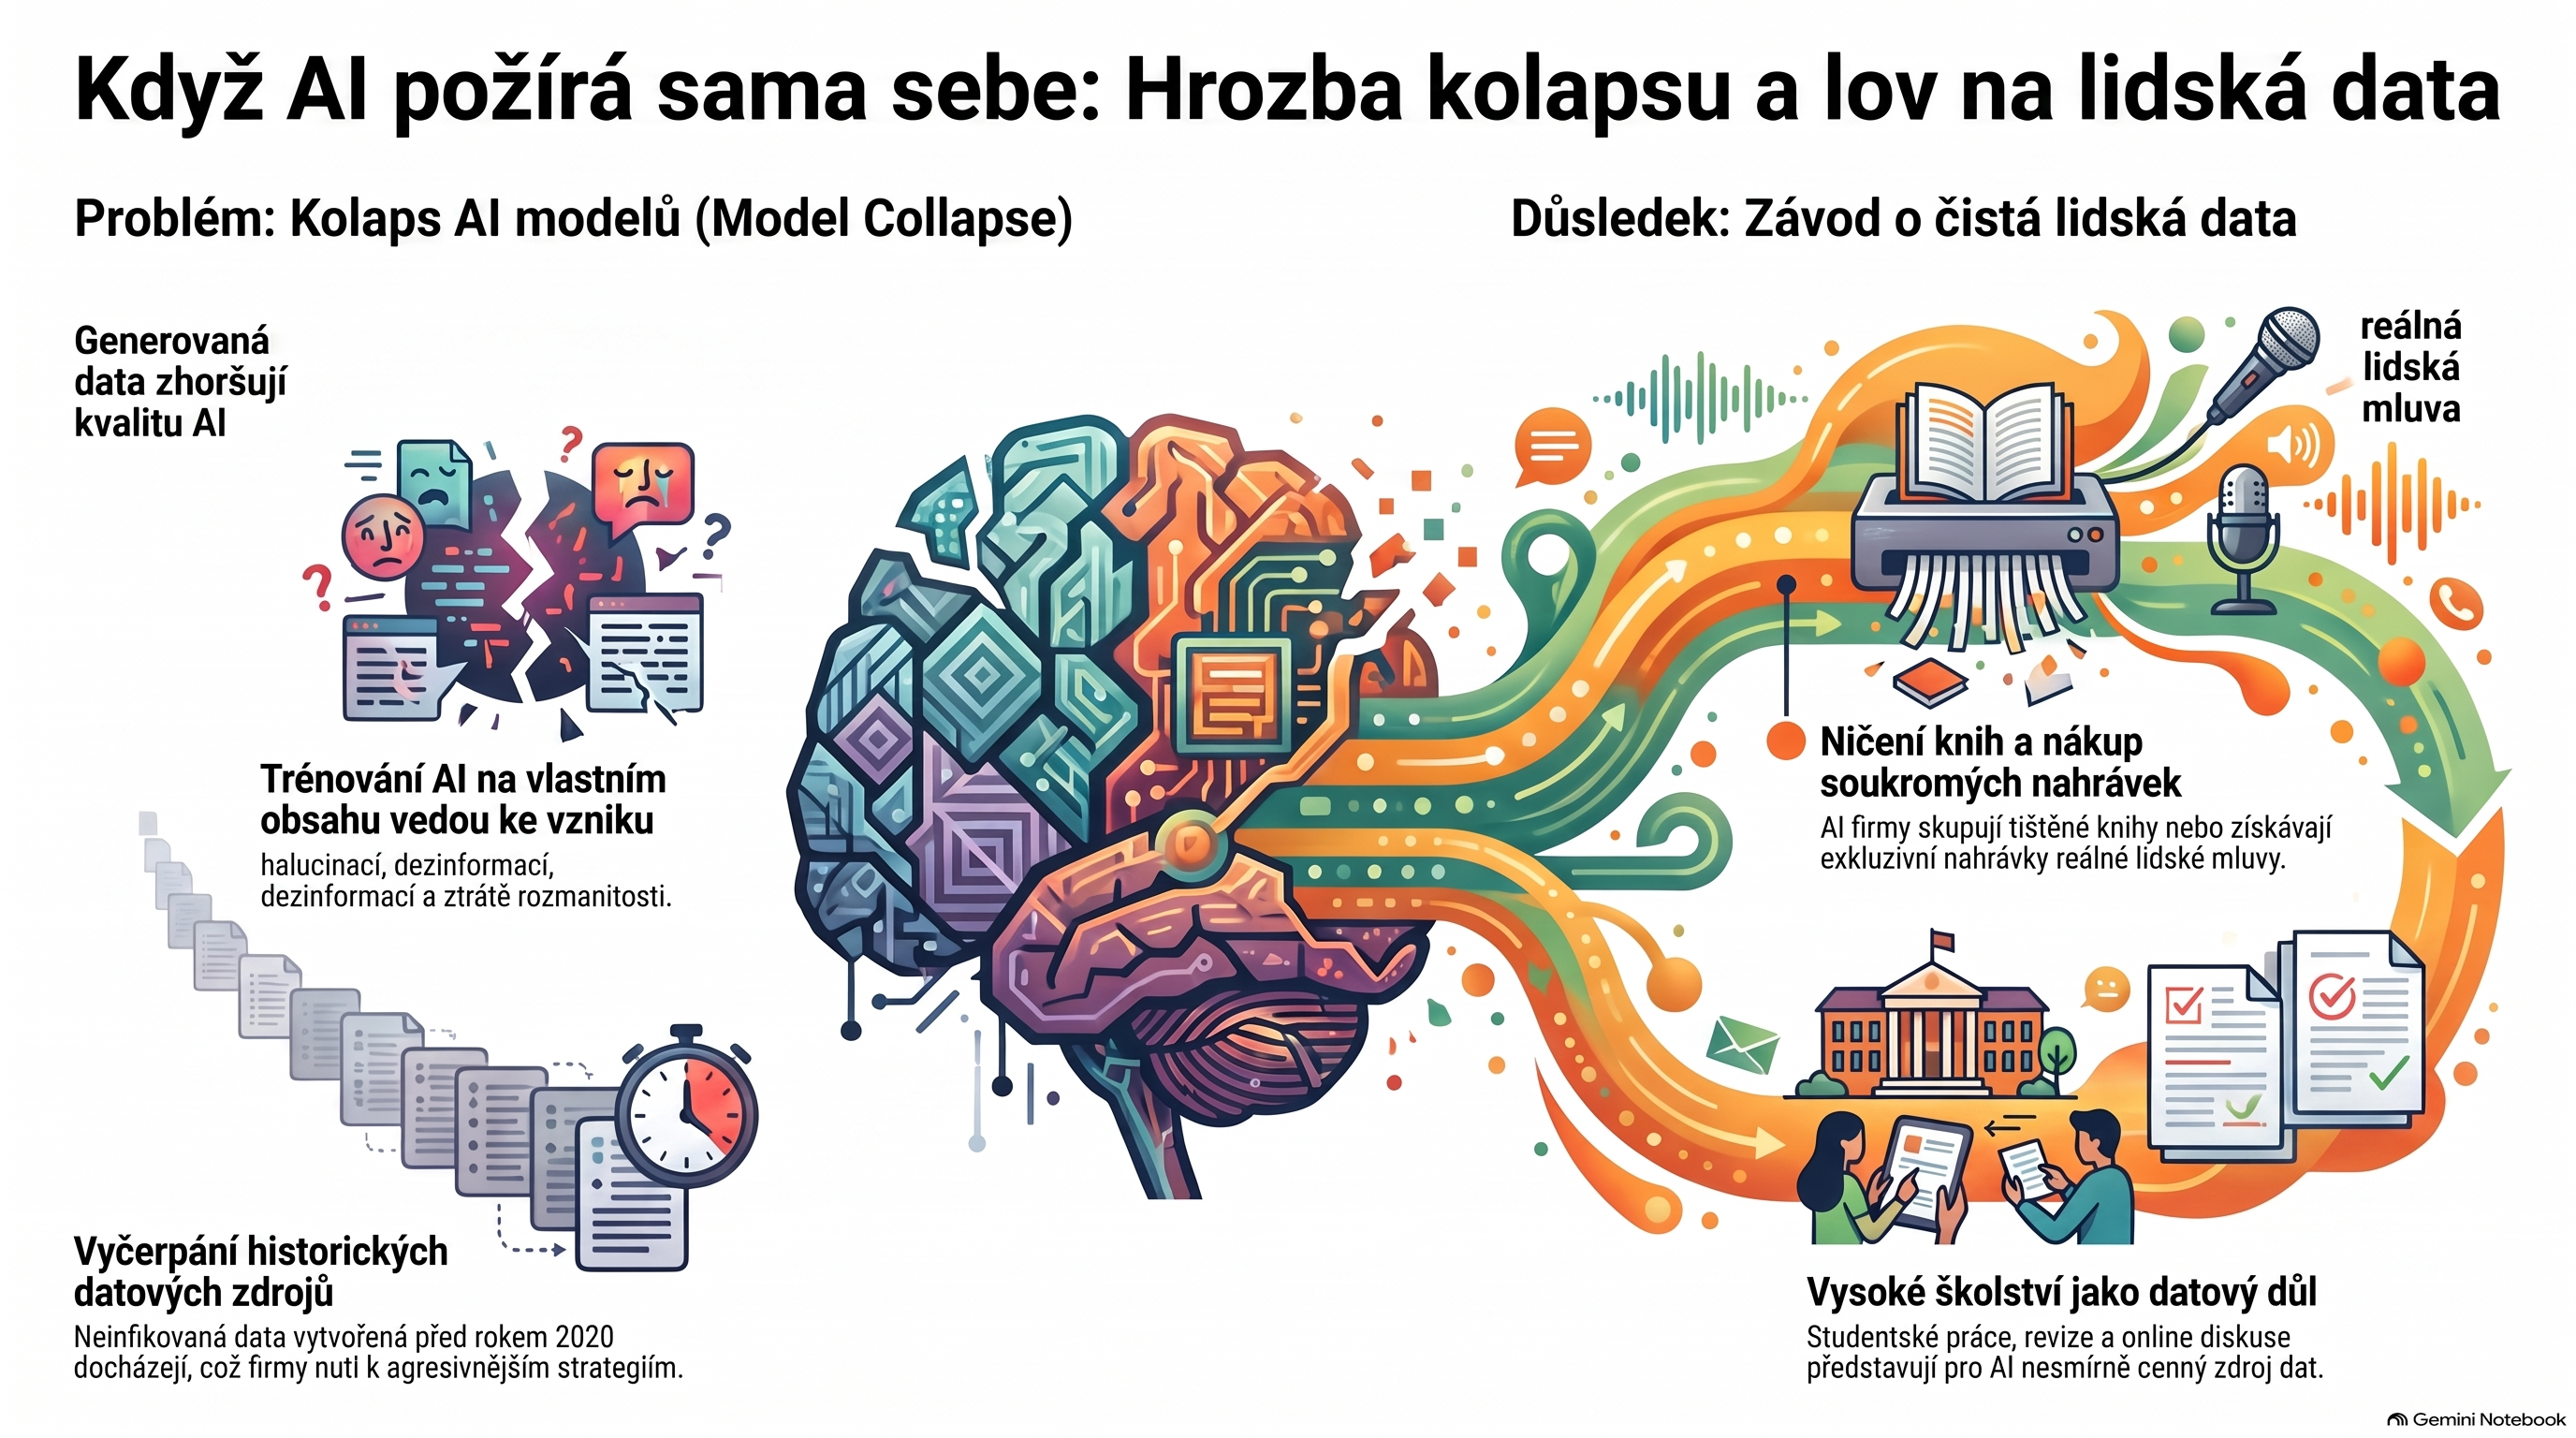
Infografika na základě zdroje generovaná Gemini Notebookem
PS. Martin svůj příspěvek na svém blogu nazval „Slop Will Eat Itself“ (Šlichta sežere sama sebe). Vzpomněl si totiž na kapelu Pop Will Eat Itself, na jejímž koncertě ho v 80. letech málem zmlátili.
Tento materiál je publikován pod licencí Creative Commons – Uveďte původ – Neužívejte komerčně – Nezpracovávejte 4.0.